
11/07/2026 – (AIHanhChinhCong.vn) – ChatGPT Work có thể đọc tài liệu, phân tích bảng tính, tổng hợp nhiều nguồn và tạo báo cáo, kế hoạch hoặc bài trình bày. Tuy nhiên, kết quả chỉ đáng tin cậy khi dữ liệu đầu vào được chuẩn bị đúng cách. Một tập tài liệu lộn xộn, chứa nhiều phiên bản, thiếu nguồn gốc hoặc có thông tin nhạy cảm sẽ khiến AI dễ bỏ sót, nhầm số liệu, diễn giải sai hoặc tạo ra một văn bản nghe hợp lý nhưng không đủ căn cứ để sử dụng.
Trong hành chính công, chuẩn bị dữ liệu không chỉ là đổi tên tệp rồi tải lên hệ thống. Đây là một quy trình nghiệp vụ gồm xác định mục đích sử dụng, phân loại mức độ nhạy cảm, kiểm tra quyền truy cập, loại bỏ dữ liệu không cần thiết, chuẩn hóa cấu trúc, xác minh nguồn, lập danh mục và kiểm thử trước khi giao nhiệm vụ chính thức cho AI.
ChatGPT Work được OpenAI công bố ngày 09/07/2026 với khả năng làm việc trên các tệp, ứng dụng được kết nối và quy trình nhiều bước. Người dùng có thể theo dõi tiến độ, điều chỉnh hướng xử lý và phê duyệt các hành động quan trọng. Chính vì công cụ có thể tiếp cận nhiều nguồn và tạo ra sản phẩm hoàn chỉnh, cơ quan càng cần kiểm soát dữ liệu từ trước, thay vì chỉ kiểm tra văn bản sau khi AI đã xử lý.
Nguyên tắc cốt lõi: Không đưa cho ChatGPT Work toàn bộ dữ liệu đang có. Chỉ cung cấp phần dữ liệu được phép sử dụng, thực sự cần cho nhiệm vụ, đã được kiểm tra và có thể truy ngược về nguồn.
Vì sao chuẩn bị dữ liệu quyết định chất lượng của ChatGPT Work?
ChatGPT Work có thể xử lý nhiều loại tài liệu thông dụng như PDF, DOCX, PPTX, XLSX, XLS, CSV, TSV và TXT. Hệ thống có thể tổng hợp nhiều tài liệu, so sánh văn bản, trích xuất thông tin và phân tích bảng tính. Tuy nhiên, từng loại tệp được xử lý theo cách khác nhau: văn bản thường được trích xuất nội dung, bảng tính thường được phân tích bằng mã và hình ảnh được xử lý bằng khả năng thị giác. Vì vậy, định dạng tệp và cấu trúc dữ liệu ảnh hưởng trực tiếp đến độ chính xác của kết quả.
Ví dụ, một bảng Excel có ba dòng tiêu đề, nhiều ô gộp, màu nền dùng để biểu thị trạng thái nhưng không có cột giải thích sẽ khó phân tích hơn một bảng có duy nhất một hàng tiêu đề và mỗi trạng thái được ghi rõ bằng chữ. Tương tự, một bản PDF là ảnh quét bị nghiêng, mờ hoặc mất trang sẽ có nguy cơ được đọc thiếu hơn một tệp PDF có lớp văn bản rõ ràng.
Chất lượng dữ liệu còn liên quan đến trách nhiệm giải trình. Khi ChatGPT Work tạo báo cáo tổng hợp, cán bộ phải biết mỗi số liệu đến từ tài liệu nào, do đơn vị nào cung cấp, thuộc kỳ báo cáo nào và đã được xác minh hay chưa. Nếu không thiết lập thông tin này từ đầu, việc kiểm tra sản phẩm cuối cùng sẽ tốn thời gian và có thể không thực hiện được.
Bước 1: Xác định nhiệm vụ trước khi thu thập dữ liệu
Không nên bắt đầu bằng câu hỏi “đang có những tệp nào?”. Câu hỏi đúng phải là “sản phẩm cần tạo là gì và cần dữ liệu nào để tạo sản phẩm đó?”. Việc xác định nhiệm vụ giúp tránh tải quá nhiều dữ liệu không liên quan, đồng thời giảm nguy cơ đưa thông tin nhạy cảm vào hệ thống một cách không cần thiết.
Cán bộ nên lập một phiếu mô tả nhiệm vụ ngắn. Phiếu này cần ghi rõ sản phẩm đầu ra, đối tượng sử dụng, kỳ dữ liệu, phạm vi đơn vị, tiêu chí chất lượng và người phê duyệt. Chẳng hạn, nếu nhiệm vụ là tạo báo cáo tình hình giải quyết thủ tục hành chính tháng 6/2026, dữ liệu cần thiết có thể gồm số hồ sơ tiếp nhận, số đã giải quyết, số đúng hạn, quá hạn, đang xử lý và nguyên nhân chậm. Hồ sơ chi tiết của từng công dân có thể không cần thiết cho báo cáo tổng hợp.
Có thể sử dụng mẫu sau:
Tên nhiệm vụ: Tổng hợp báo cáo giải quyết thủ tục hành chính tháng 6/2026

Sản phẩm đầu ra:
- Báo cáo Word theo mẫu của cơ quan;
- Một bảng số liệu tổng hợp;
- Danh sách đơn vị còn thiếu dữ liệu;
- Năm nhận định phục vụ giao ban.

Phạm vi:
- Các bộ phận chuyên môn thuộc đơn vị;
- Dữ liệu từ ngày 01/06/2026 đến hết ngày 30/06/2026.

Không thuộc phạm vi:
- Hồ sơ cá nhân chi tiết;
- Tài liệu ngoài kỳ báo cáo;
- Dự thảo chưa được đơn vị xác nhận;
- Tài liệu không rõ nguồn.

Người kiểm tra dữ liệu: [Họ tên/chức vụ]
Người phê duyệt sản phẩm: [Họ tên/chức vụ]
Sau khi hoàn thành phiếu này, cán bộ mới bắt đầu thu thập dữ liệu. Cách làm đó giúp chuyển từ tư duy “đưa tài liệu cho AI đọc” sang tư duy “cấp đúng dữ liệu để AI thực hiện một nhiệm vụ xác định”.
Bước 2: Lập danh mục toàn bộ nguồn dữ liệu
Dữ liệu phục vụ một nhiệm vụ hành chính thường nằm tại nhiều nơi: hệ thống quản lý văn bản, thư điện tử, OneDrive, SharePoint, Teams, thư mục máy tính, phần mềm chuyên ngành hoặc tệp do các đơn vị gửi. Trước khi kết nối hoặc tải tệp, cần lập danh mục nguồn để biết chính xác AI có thể được tiếp cận phần nào.
Các ứng dụng kết nối có thể cho phép ChatGPT tìm kiếm, tham chiếu, đồng bộ hoặc thực hiện hành động trên dịch vụ bên ngoài. Quyền cụ thể phụ thuộc vào cấu hình, ứng dụng và chính sách quản trị của không gian làm việc. Quản trị viên có thể kiểm soát ứng dụng nào được bật và hành động nào cần người dùng phê duyệt.
Danh mục nguồn nên có ít nhất các trường sau:
| Mã nguồn | Tên nguồn hoặc tệp | Đơn vị cung cấp | Thời gian dữ liệu | Chủ sở hữu | Mức độ nhạy cảm | Trạng thái |
|---|---|---|---|---|---|---|
| N01 | Báo cáo tháng 6 – Bộ phận Một cửa | Bộ phận Một cửa | 01–30/06/2026 | Văn phòng | Nội bộ | Đã xác minh |
| N02 | tonghop_moi.xlsx | Chưa xác định | Không rõ | Không rõ | Chưa đánh giá | Không sử dụng |
| N03 | Phụ lục hồ sơ quá hạn | Bộ phận chuyên môn | 01–30/06/2026 | Trưởng bộ phận | Có dữ liệu cá nhân | Cần khử định danh |
| N04 | Mẫu báo cáo chính thức | Văn phòng | Phiên bản 2026 | Văn phòng | Nội bộ | Được phép sử dụng |
Bảng danh mục không chỉ phục vụ chuẩn bị ban đầu. Sau này, bảng còn là cơ sở để đối chiếu báo cáo, điều tra sai lệch và chứng minh nguồn dữ liệu đã được sử dụng. Những tệp không xác định được chủ sở hữu, kỳ dữ liệu hoặc tình trạng phê duyệt nên được đặt vào nhóm cách ly, chưa đưa cho AI.
Bước 3: Phân loại dữ liệu theo mức độ nhạy cảm
Đây là bước bắt buộc đối với cơ quan nhà nước. Cán bộ không nên quyết định chỉ dựa trên cảm giác rằng tài liệu “không quá quan trọng”. Việc phân loại phải căn cứ quy định pháp luật, danh mục bí mật nhà nước, quy chế bảo vệ dữ liệu, quy chế an toàn thông tin và quy định nội bộ của cơ quan.
Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15 được ban hành ngày 26/06/2025 và có hiệu lực từ ngày 01/01/2026. Nghị định số 356/2025/NĐ-CP quy định chi tiết một số điều và biện pháp thi hành luật này cũng có hiệu lực từ ngày 01/01/2026. Bên cạnh đó, Luật Bảo vệ bí mật nhà nước số 117/2025/QH15 có hiệu lực từ ngày 01/03/2026. Đây là những căn cứ quan trọng mà cơ quan phải xem xét khi xây dựng quy trình sử dụng AI với dữ liệu công vụ.
Một mô hình phân loại thực hành có thể gồm bốn mức:
| Mức | Đặc điểm | Ví dụ | Cách xử lý với ChatGPT Work |
|---|---|---|---|
| Mức 1 – Công khai | Đã được phép công bố rộng rãi | Văn bản đã đăng công báo, thông tin trên cổng điện tử | Có thể sử dụng trong môi trường được phép |
| Mức 2 – Nội bộ | Phục vụ hoạt động cơ quan, chưa công khai | Báo cáo điều hành, kế hoạch nội bộ | Chỉ dùng trong không gian làm việc được cơ quan phê duyệt |
| Mức 3 – Nhạy cảm | Có dữ liệu cá nhân, tài chính, hồ sơ vụ việc hoặc thông tin hạn chế | Danh sách công dân, hồ sơ khiếu nại, thông tin cán bộ | Cần đánh giá, giảm thiểu, khử định danh và phê duyệt |
| Mức 4 – Cấm đưa vào | Bí mật nhà nước, thông tin mật hoặc dữ liệu bị cấm theo quy định | Tài liệu mang độ mật, tài khoản và khóa truy cập | Không đưa vào ChatGPT Work nếu chưa có cơ chế chuyên biệt được phép |
Bảng trên chỉ là khung nghiệp vụ tham khảo, không thay thế danh mục và quy chế của cơ quan. Nếu cán bộ chưa xác định chắc chắn một tệp thuộc mức nào, phải coi đó là dữ liệu chưa được phép sử dụng cho đến khi có ý kiến của người phụ trách.
Bước 4: Áp dụng nguyên tắc giảm thiểu dữ liệu
Giảm thiểu dữ liệu có nghĩa là chỉ sử dụng những trường thông tin thực sự cần để hoàn thành nhiệm vụ. Đây là khác biệt quan trọng giữa “có quyền truy cập” và “cần đưa cho AI”. Một cán bộ có thể được quyền xem hồ sơ đầy đủ, nhưng báo cáo thống kê chỉ cần mã hồ sơ, lĩnh vực, ngày tiếp nhận, ngày hẹn trả và trạng thái.
Ví dụ, bảng nguồn đang có các cột họ tên, ngày sinh, số định danh, số điện thoại, địa chỉ, loại thủ tục, ngày tiếp nhận và trạng thái. Nếu mục tiêu là tính tỷ lệ giải quyết đúng hạn, các trường họ tên, ngày sinh, số định danh, số điện thoại và địa chỉ thường không cần cho phép tính. Những cột đó nên được loại khỏi bản dữ liệu dùng cho AI.
Cán bộ có thể thực hiện ba thao tác giảm thiểu:
- Loại bỏ trường không cần thiết: Xóa các cột, trang hoặc phụ lục không phục vụ mục tiêu.
- Khử định danh: Thay tên và mã định danh thật bằng mã như HS001, HS002.
- Tổng hợp trước khi cung cấp: Chuyển dữ liệu cá nhân thành số lượng theo nhóm nếu AI chỉ cần phân tích thống kê.
Sau khi giảm thiểu, cần kiểm tra khả năng tái nhận diện. Chỉ thay tên bằng mã chưa chắc đã an toàn nếu tệp vẫn giữ địa chỉ cụ thể, số điện thoại hoặc mô tả vụ việc hiếm gặp. Việc khử định danh phải xét tổng thể các trường còn lại, không chỉ một cột.
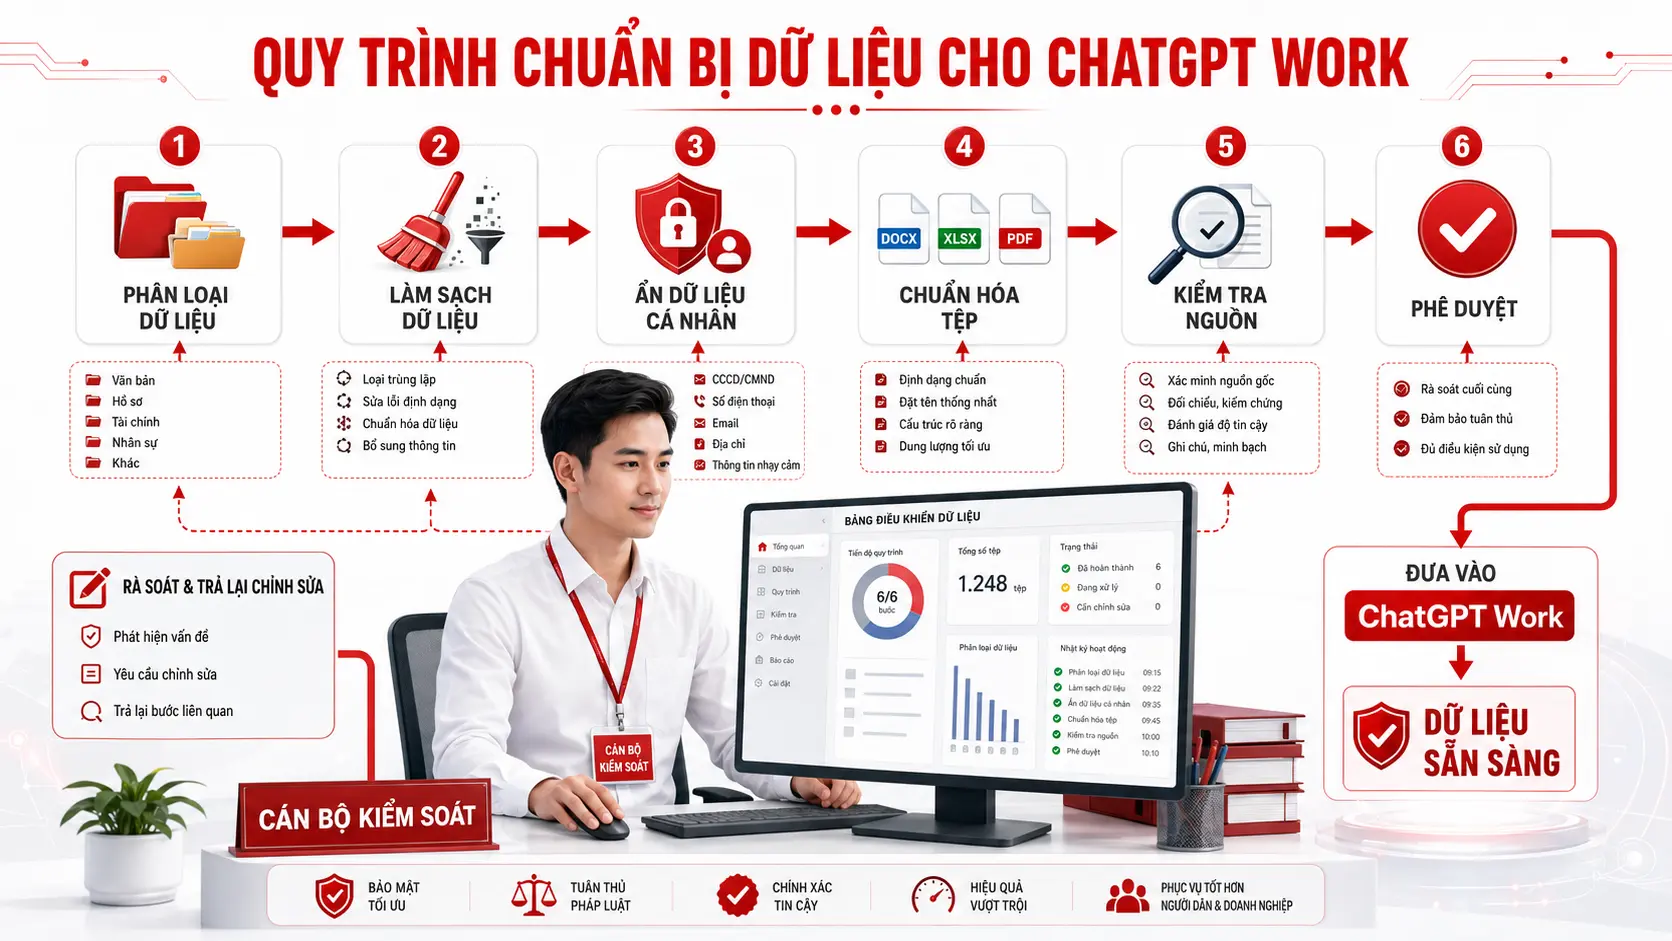
Chỉ giữ lại các trường dữ liệu cần thiết cho mục tiêu phân tích, thay vì đưa toàn bộ hồ sơ cho AI.
Bước 5: Chọn đúng định dạng tệp
ChatGPT hỗ trợ nhiều định dạng phổ biến, nhưng “được hỗ trợ” không có nghĩa mọi tệp đều mang lại chất lượng như nhau. Đối với tài liệu văn bản, nên ưu tiên DOCX, PDF có lớp văn bản hoặc TXT. Đối với dữ liệu dạng bảng, nên ưu tiên XLSX hoặc CSV có cấu trúc rõ ràng. Google Docs dạng .gdoc hiện không được hỗ trợ trực tiếp; nên xuất sang PDF hoặc DOCX trước khi sử dụng.
Đối với PDF quét, cần kiểm tra xem có thể bôi chọn và sao chép chữ hay không. Nếu không, tệp có thể chỉ chứa hình ảnh. Khi đó, nên thực hiện nhận dạng ký tự, kiểm tra lại nội dung sau nhận dạng và bảo đảm các trang không bị xoay, cắt hoặc mờ. Riêng biểu mẫu có bảng phức tạp, con dấu hoặc chữ viết tay cần được kiểm tra thủ công vì khả năng nhận diện có thể không hoàn hảo.
Đối với Excel, hãy chuẩn hóa theo các nguyên tắc sau:
- Một hàng tiêu đề duy nhất;
- Một dòng tương ứng một bản ghi;
- Một cột chỉ chứa một loại dữ liệu;
- Không dùng ô gộp trong vùng dữ liệu;
- Không dùng màu sắc như thông tin duy nhất;
- Ngày, số tiền và tỷ lệ sử dụng định dạng nhất quán;
- Không chèn tổng cộng vào giữa vùng dữ liệu;
- Công thức phải được kiểm tra và không chứa liên kết lỗi;
- Mỗi bảng nên có một trang tính riêng và tên dễ hiểu.
Sau khi chuẩn hóa, nên lưu một bản dữ liệu gốc ở chế độ chỉ đọc và tạo một bản sao dành riêng cho ChatGPT Work. Không chỉnh sửa trực tiếp tệp gốc trong quá trình thử nghiệm.
Bước 6: Làm sạch và chuẩn hóa nội dung
Làm sạch dữ liệu không có nghĩa sửa dữ liệu để “đẹp hơn”. Mục tiêu là phát hiện vấn đề, chuẩn hóa cách biểu diễn và giữ lại dấu vết của mọi thay đổi. Không được tự ý thay số liệu chỉ vì một giá trị trông bất thường.
Với dữ liệu bảng, cần kiểm tra ít nhất sáu nhóm lỗi: dòng trùng, ô trống, sai kiểu dữ liệu, khác đơn vị tính, ngày tháng không thống nhất và giá trị ngoại lệ. Ví dụ, một đơn vị báo cáo số tiền theo đồng, đơn vị khác theo triệu đồng; nếu không chuẩn hóa, kết quả tổng hợp có thể sai rất lớn.
Với tài liệu văn bản, cần kiểm tra tên cơ quan, số ký hiệu, ngày ban hành, kỳ báo cáo, trạng thái bản nháp và tính đầy đủ của phụ lục. Nếu có nhiều phiên bản, cần xác định rõ bản nào là bản chính. Không nên để song song các tệp như BaoCaoMoi.docx, BaoCaoMoi2.docx và BaoCaoMoi_Chot_LanCuoi.docx.
Một nhật ký làm sạch đơn giản có thể ghi:
| Thời điểm | Tệp | Vấn đề | Cách xử lý | Người thực hiện | Trạng thái xác minh |
|---|---|---|---|---|---|
| 10/07/2026 | N03.xlsx | Hai dòng trùng mã hồ sơ | Chưa xóa, chuyển sang danh sách cần xác minh | Nguyễn A | Chờ bộ phận chuyên môn |
| 10/07/2026 | N01.docx | Thiếu kỳ báo cáo | Đối chiếu công văn gửi kèm | Nguyễn A | Đã xác minh |
| 10/07/2026 | N05.xlsx | Đơn vị tính không đồng nhất | Quy đổi về triệu đồng theo nguồn | Nguyễn B | Đã kiểm tra |
Nhật ký giúp phân biệt dữ liệu gốc với dữ liệu đã được xử lý. Khi xuất hiện sai lệch, cán bộ có thể truy lại ai đã thay đổi nội dung nào và dựa trên căn cứ nào.
Bước 7: Đặt tên tệp và quản lý phiên bản
Tên tệp phải giúp người khác hiểu nội dung mà không cần mở tệp. Một quy tắc phù hợp có thể là:
YYYYMMDD_DonVi_LoaiTaiLieu_KyDuLieu_PhiênBan_TrangThai.extVí dụ:
20260705_BoPhanMotCua_BaoCaoTTHC_202606_v01_DaXacMinh.docx
20260708_VanPhong_TongHopTTHC_202606_v03_ChoPheDuyet.xlsx
20260710_UBNDXa_MauBaoCaoTTHC_2026_v02_ChinhThuc.docx
Không nên dùng các từ như “mới”, “cuối”, “chuẩn” hoặc “chốt” mà không có số phiên bản và trạng thái. Một tệp được gọi là “cuối” hôm nay có thể bị thay đổi vào ngày mai. Số phiên bản, ngày và trạng thái giúp ChatGPT Work cũng như người dùng phân biệt đúng nguồn.
Trong thư mục nhiệm vụ, có thể tổ chức thành bốn nhóm: 01_NguonGoc, 02_DaLamSach, 03_MauDauRa và 04_KetQuaAI. Tệp gốc không chỉnh sửa; tệp đã làm sạch có nhật ký; mẫu đầu ra được phê duyệt; sản phẩm AI được lưu riêng để tránh nhầm với văn bản chính thức.
Bước 8: Tạo tệp “README dữ liệu” để hướng dẫn AI
README là tệp mô tả bộ dữ liệu. Đây là một trong những cách hiệu quả nhất để giảm hiểu nhầm. Thay vì để ChatGPT Work tự đoán ý nghĩa của XL_DH, HS_TN hoặc số 0 trong một cột, cán bộ giải thích rõ từng trường.
Mẫu README có thể viết như sau:
TÊN BỘ DỮ LIỆU
Báo cáo giải quyết thủ tục hành chính tháng 6/2026

MỤC ĐÍCH
Phục vụ tổng hợp báo cáo nội bộ và chuẩn bị nội dung giao ban.

PHẠM VI THỜI GIAN
Từ 01/06/2026 đến 30/06/2026.

NGUỒN
Các bộ phận chuyên môn gửi Văn phòng.
Danh mục chi tiết nằm trong file DanhMucNguon.xlsx.

QUY ƯỚC
- HS_TN: Hồ sơ tiếp nhận.
- HS_DQ: Hồ sơ đã giải quyết.
- DUNG_HAN = 1: Giải quyết đúng hoặc trước hạn.
- DUNG_HAN = 0: Giải quyết quá hạn.
- Ô trống: Chưa có dữ liệu, không được hiểu là 0.
- Đơn vị thời gian: Ngày làm việc.

GIỚI HẠN
- Không dùng dữ liệu để đánh giá cá nhân.
- Không suy đoán nguyên nhân chậm nếu nguồn không nêu.
- Không công bố danh sách hồ sơ.
- Mọi số liệu tổng hợp phải dẫn mã nguồn.

NGƯỜI PHỤ TRÁCH DỮ LIỆU
[Họ tên, bộ phận, thông tin liên hệ nội bộ]
README nên được viết bằng ngôn ngữ nghiệp vụ dễ hiểu. Không nên giả định AI hoặc người dùng khác biết các từ viết tắt nội bộ. Với bảng tính phức tạp, nên bổ sung một “từ điển dữ liệu” gồm tên cột, ý nghĩa, kiểu dữ liệu, đơn vị tính, giá trị hợp lệ và quy tắc xử lý ô trống.
Bước 9: Kiểm soát quyền truy cập và ứng dụng kết nối
Tải từng tệp lên và kết nối toàn bộ SharePoint là hai mức truy cập rất khác nhau. Khi kết nối nguồn nội bộ, cơ quan phải xác định ai được tìm kiếm dữ liệu, phạm vi thư mục nào được lập chỉ mục, ứng dụng có quyền đọc hay ghi và hành động nào cần phê duyệt.
OpenAI cho biết quản trị viên không gian làm việc có thể kiểm soát ứng dụng được bật, quyền truy cập và hành động. Một số ứng dụng hỗ trợ tìm kiếm, đồng bộ dữ liệu hoặc hành động ghi. Mặc định đối với một số cấu hình, hệ thống có thể đọc dữ liệu nhưng yêu cầu xác nhận trước hành động có ảnh hưởng đáng kể, làm lộ thông tin nhạy cảm hoặc khó hoàn tác. Tuy nhiên, cơ quan không nên chỉ dựa vào mặc định; cần cấu hình theo nguyên tắc quyền tối thiểu.
Trước khi kích hoạt kết nối, quản trị viên cần trả lời:
- Nguồn dữ liệu nào thực sự cần kết nối?
- Nhóm người dùng nào được sử dụng?
- Hệ thống có giữ nguyên quyền truy cập từ nguồn hay không?
- Dữ liệu có được đồng bộ hoặc lập chỉ mục trước không?
- Ai có quyền cho phép hành động ghi?
- Có nhật ký để kiểm tra truy cập và hành động không?
- Có quy trình thu hồi quyền khi cán bộ chuyển vị trí không?
OpenAI công bố rằng dữ liệu của các sản phẩm doanh nghiệp không được dùng để huấn luyện mô hình theo mặc định; tổ chức có thể kiểm soát nguồn nội bộ được kết nối, quyền truy cập và, đối với một số gói, thời gian lưu giữ. Tuy nhiên, cơ quan vẫn phải đánh giá điều khoản hợp đồng, cấu hình thực tế, nơi lưu trữ, ứng dụng bên thứ ba và nghĩa vụ pháp lý của mình trước khi triển khai.
Bước 10: Kiểm thử bộ dữ liệu trước khi giao nhiệm vụ chính thức
Không nên tải dữ liệu lên rồi yêu cầu ChatGPT Work viết ngay báo cáo. Trước hết, cần kiểm tra xem AI đã đọc và hiểu đúng bộ dữ liệu chưa. Đây là bước “nghiệm thu đầu vào”.
Có thể sử dụng câu lệnh kiểm thử sau:
Chưa phân tích và chưa tạo báo cáo.

Hãy kiểm kê toàn bộ tệp được cung cấp và lập bảng gồm:
1. Tên tệp;
2. Loại tệp;
3. Đơn vị cung cấp;
4. Kỳ dữ liệu;
5. Nội dung chính;
6. Mức độ đầy đủ;
7. Dữ liệu cá nhân hoặc thông tin nhạy cảm phát hiện được;
8. Mâu thuẫn hoặc trường hợp chưa rõ;
9. Khả năng sử dụng: dùng được, cần xác minh hoặc không nên dùng.

Chỉ mô tả những gì thực sự có trong tệp.
Không tự bổ sung thông tin.
Dẫn tên tệp cho mọi nhận xét.
Sau đó, yêu cầu AI giải thích cách hiểu dữ liệu:
Hãy lập từ điển dữ liệu từ các bảng tính đã cung cấp.
Với mỗi cột, nêu:
- Tên cột;
- Ý nghĩa bạn đang hiểu;
- Kiểu dữ liệu;
- Đơn vị tính;
- Giá trị hợp lệ;
- Cách hiểu ô trống;
- Điểm cần tôi xác nhận.

Chưa thực hiện phép tính.
Cán bộ phải đối chiếu kết quả với README và nguồn gốc. Nếu AI hiểu sai một trường, cần sửa hướng dẫn hoặc cấu trúc dữ liệu trước khi tiếp tục. Không nên chỉ giải thích tạm thời trong hội thoại rồi bỏ qua lỗi cấu trúc, bởi lỗi đó có thể tái diễn ở lần xử lý tiếp theo.
Ví dụ thực hành hoàn chỉnh: Chuẩn bị dữ liệu báo cáo thủ tục hành chính
Giả sử Văn phòng nhận năm tệp Excel từ năm bộ phận. Mục tiêu là tổng hợp số hồ sơ tiếp nhận, giải quyết đúng hạn, quá hạn và đang xử lý. Các tệp ban đầu có tên khác nhau, dùng đơn vị thời gian khác nhau và chứa họ tên, số điện thoại của công dân.
Quy trình chuẩn bị được thực hiện như sau. Trước hết, Văn phòng lập phiếu nhiệm vụ và xác định báo cáo không cần thông tin nhận dạng công dân. Tiếp theo, cán bộ lập danh mục năm nguồn, xác nhận kỳ dữ liệu và người cung cấp. Những tệp chưa được trưởng bộ phận xác nhận được đánh dấu “chờ xác minh”.
Sau đó, cán bộ tạo bản sao, xóa khỏi bản dùng cho AI các cột họ tên, số định danh, số điện thoại và địa chỉ. Mỗi hồ sơ được thay bằng một mã ngẫu nhiên. Các cột ngày được đưa về định dạng thống nhất; trạng thái được chuẩn hóa thành DUNG_HAN, QUA_HAN và DANG_XU_LY. Ô trống được giữ nguyên và mô tả là “chưa có dữ liệu”, không được tự động tính thành 0.
Cuối cùng, bộ dữ liệu gồm:
01_NguonGoc/
02_DaLamSach/
  20260710_BoPhanA_TTHC_202606_v01_DaXacMinh.xlsx
  20260710_BoPhanB_TTHC_202606_v01_DaXacMinh.xlsx
  ...
03_MauDauRa/
  20260105_VanPhong_MauBaoCaoTTHC_2026_v02_ChinhThuc.docx
README_DuLieu.txt
DanhMucNguon.xlsx
NhatKyLamSach.xlsx
Trước khi yêu cầu tạo báo cáo, cán bộ cho ChatGPT Work kiểm kê tệp, lập từ điển dữ liệu, chỉ ra số liệu thiếu và dừng để xác nhận. Chỉ sau khi đầu vào được nghiệm thu, AI mới được phép tính toán và tạo dự thảo.
Danh mục kiểm tra trước khi bấm tải lên hoặc kết nối
Trước mỗi nhiệm vụ, cán bộ có thể sử dụng danh mục kiểm tra dưới đây. Nếu có bất kỳ câu trả lời “không” hoặc “chưa rõ”, dữ liệu chưa nên được đưa vào ChatGPT Work.
| Câu hỏi kiểm tra | Có | Không | Chưa rõ |
|---|---|---|---|
| Nhiệm vụ và sản phẩm đầu ra đã được xác định rõ? | ☐ | ☐ | ☐ |
| Dữ liệu thực sự cần cho nhiệm vụ? | ☐ | ☐ | ☐ |
| Nguồn, chủ sở hữu và kỳ dữ liệu đã được xác định? | ☐ | ☐ | ☐ |
| Tài liệu đã được phân loại mức độ nhạy cảm? | ☐ | ☐ | ☐ |
| Không có bí mật nhà nước hoặc dữ liệu bị cấm? | ☐ | ☐ | ☐ |
| Dữ liệu cá nhân đã được giảm thiểu hoặc khử định danh? | ☐ | ☐ | ☐ |
| Tệp đã được làm sạch nhưng vẫn giữ bản gốc? | ☐ | ☐ | ☐ |
| Tên tệp, phiên bản và trạng thái đã rõ? | ☐ | ☐ | ☐ |
| Có README, từ điển dữ liệu và danh mục nguồn? | ☐ | ☐ | ☐ |
| Quyền truy cập và ứng dụng kết nối đã được phê duyệt? | ☐ | ☐ | ☐ |
| Có người kiểm tra dữ liệu và người phê duyệt sản phẩm? | ☐ | ☐ | ☐ |
| Có kế hoạch lưu vết, lưu giữ và xóa dữ liệu? | ☐ | ☐ | ☐ |
Danh mục này nên được chuyển thành biểu mẫu nội bộ thay vì chỉ dựa vào trí nhớ của từng cán bộ. Với nhiệm vụ định kỳ, cơ quan có thể tích hợp biểu mẫu vào quy trình báo cáo tháng hoặc quy trình chuẩn bị họp.
Những sai lầm thường gặp cần tránh
Sai lầm thứ nhất là tải toàn bộ thư mục cho AI với suy nghĩ “càng nhiều dữ liệu càng tốt”. Trên thực tế, quá nhiều tài liệu không liên quan làm tăng nhiễu, khó phân biệt phiên bản và mở rộng phạm vi truy cập không cần thiết.
Sai lầm thứ hai là dùng tệp tổng hợp không rõ nguồn. Một bảng có hàng trăm số liệu nhưng không ghi đơn vị cung cấp, kỳ dữ liệu hoặc công thức sẽ rất khó kiểm chứng. AI có thể phân tích bảng nhưng không thể tự tạo ra tính xác thực mà dữ liệu không có.
Sai lầm thứ ba là nghĩ rằng xóa tên đã đủ bảo vệ dữ liệu cá nhân. Số điện thoại, địa chỉ, mã hồ sơ, mô tả vụ việc và các thuộc tính kết hợp vẫn có thể làm lộ danh tính. Khử định danh cần đánh giá trên toàn bộ bộ dữ liệu.
Sai lầm thứ tư là để AI tự sửa dữ liệu gốc. ChatGPT Work nên phát hiện và đề xuất xử lý bất thường; quyết định sửa phải do người có trách nhiệm thực hiện, có nhật ký và căn cứ.
Sai lầm cuối cùng là nhầm sản phẩm AI với tài liệu chính thức. Mọi tệp do AI tạo cần được đánh dấu là dự thảo, lưu trong thư mục riêng và chỉ chuyển trạng thái sau khi được kiểm tra, phê duyệt theo đúng quy trình của cơ quan.
Mô hình quản trị dữ liệu tối thiểu cho một đơn vị
Một đơn vị nhỏ chưa cần xây dựng ngay hệ thống quản trị phức tạp. Tuy nhiên, tối thiểu phải xác định bốn vai trò: chủ sở hữu nghiệp vụ, người quản lý dữ liệu, người vận hành ChatGPT Work và người phê duyệt sản phẩm. Một người có thể đảm nhiệm nhiều vai trò trong đơn vị nhỏ, nhưng trách nhiệm ở từng bước vẫn phải được ghi rõ.
Đơn vị cũng nên ban hành một hướng dẫn ngắn gồm danh mục dữ liệu được phép, dữ liệu cần phê duyệt và dữ liệu không được đưa vào AI; quy tắc đặt tên tệp; biểu mẫu danh mục nguồn; quy trình xử lý sự cố; thời hạn lưu giữ; cùng cách thu hồi quyền truy cập.
Khi cần xây dựng bộ quy trình chuẩn bị dữ liệu, thư viện câu lệnh và khung kiểm soát phù hợp với từng nghiệp vụ, cơ quan có thể trao đổi với TS. Nguyễn Trung Hòa và AIHanhChinhCong.vn. Hoạt động triển khai nên bắt đầu từ một quy trình thực tế, đo được chất lượng trước và sau ứng dụng, sau đó mới mở rộng.
Chuẩn bị dữ liệu cho ChatGPT Work không phải là công việc kỹ thuật đơn thuần. Đây là bước kết nối giữa nghiệp vụ hành chính, quản trị dữ liệu, bảo vệ thông tin và khả năng của AI. Một bộ dữ liệu tốt phải đúng mục đích, đúng nguồn, đủ dùng, được phân loại, đã giảm thiểu, có cấu trúc, có phiên bản và có người chịu trách nhiệm.
Quy trình có thể tóm gọn bằng mười hành động: xác định nhiệm vụ, lập danh mục nguồn, phân loại dữ liệu, giảm thiểu thông tin, chọn định dạng, làm sạch, quản lý phiên bản, tạo README, kiểm soát quyền và kiểm thử đầu vào. Nếu thực hiện đầy đủ, ChatGPT Work sẽ có điều kiện tạo ra sản phẩm chính xác hơn, dễ kiểm chứng hơn và an toàn hơn cho hoạt động hành chính công.


